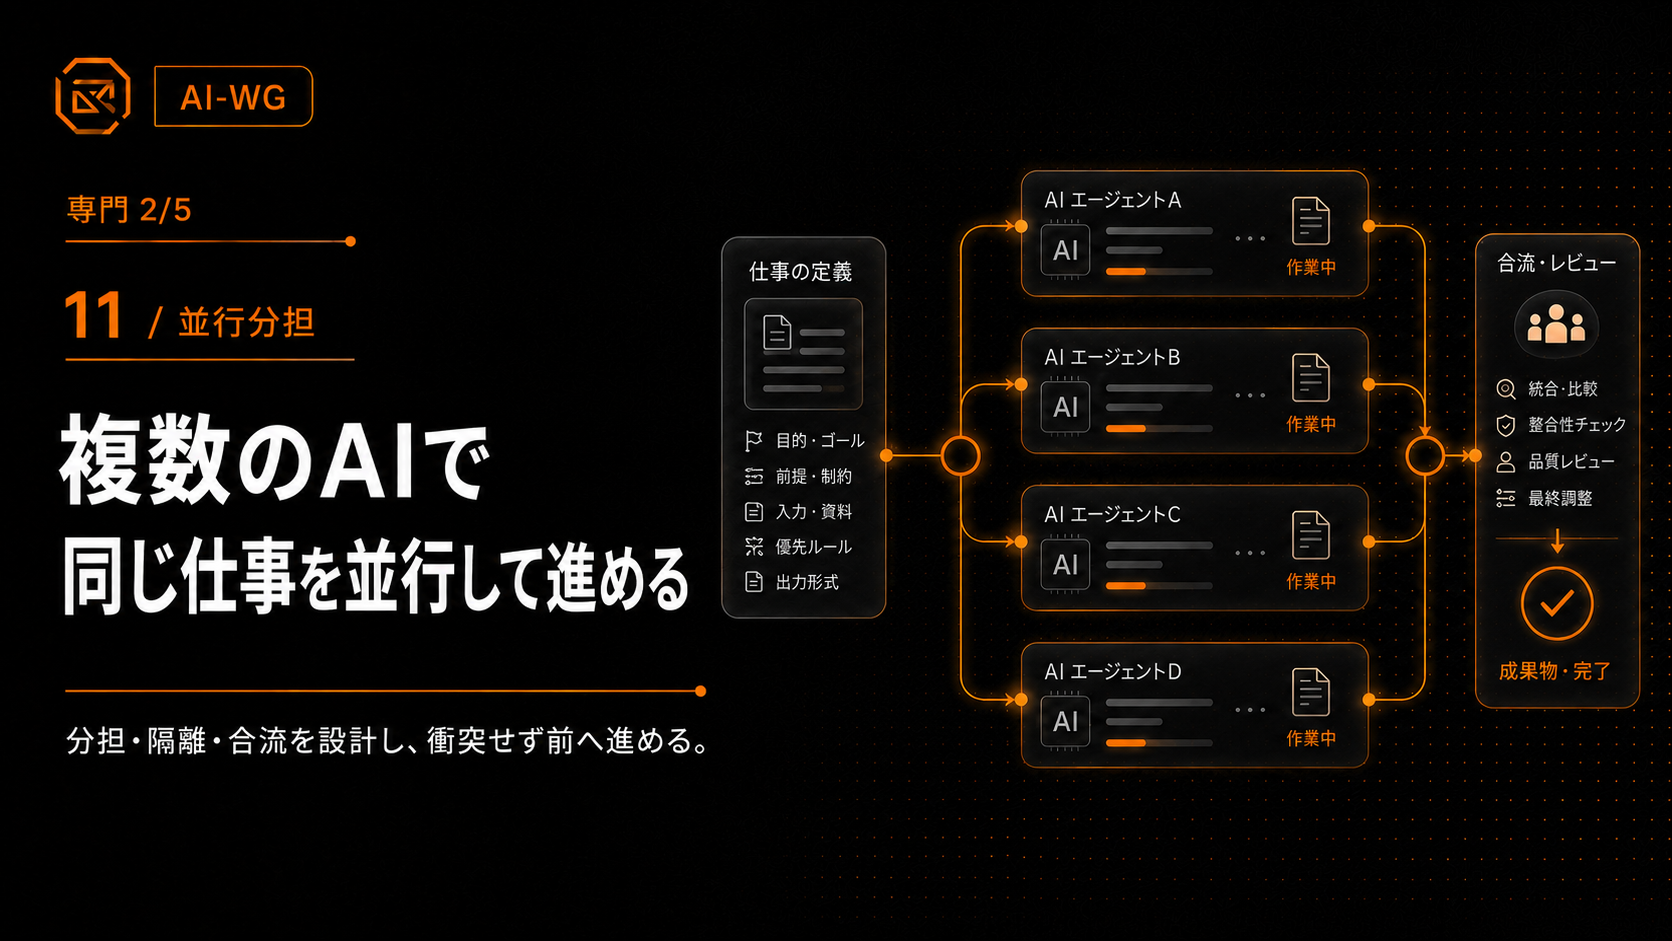
分担・隔離・合流をどう設計するか
AI Work Governance|専門テーマ — 複数AIの分担と合流
ChatGPT、Claude Code、Codexのように、仕事を任せられるAIが複数あるなら、同時に動かせば仕事も速く進みそうです。
実際、調査を一方へ、実装をもう一方へ、レビューを別のAIへ渡すことはできます。
しかし、AIを二つ起動しただけでは、仕事は二倍には進みません。
むしろ、次の問題が増えます。
- 同じ作業を二重に始める
- 別ファイルを触っているのに、意味上は衝突する
- 片方が古い前提で作業を続ける
- それぞれが「終わった」と報告するが結果が食い違う
- 最後の合流で人間の仕事が増える
難しいのは、AIを何個起動するかではありません。
一つの仕事として意味を保ったまま、複数のAI実行役へ安全に分け、結果を現在の状態へ戻せるか。
この記事では、そのための最小モデルを整理します。
まず「仕事」と「実行役」を分ける
一つのGitHub Issueを、今日はChatGPTが調査し、明日はClaude Codeが実装し、その後Codexがレビューするかもしれません。
実行役が変わるたびに仕事の意味まで作り直してしまうと、同じIssueなのに別の仕事になってしまいます。
そこで、次を分けます。
仕事の識別
  = 何を達成する仕事なのか

実行の識別
  = 誰が、どのセッションで、どの作業場所から進めているか
共有したいものと、分けたいものは違います。
flowchart TB
    accTitle: 一つの仕事を複数AIへ分担して戻す流れ
    accDescr: 共有する仕事の意味から複数AI実行役へ仕事を分け、結果を合流し、現在状態を再確認して次の仕事を決める流れを示す。
    W[共有する仕事の意味]
    W --> A[ChatGPT]
    W --> B[Claude Code]
    W --> C[Codex]
    A --> J[合流 / 矛盾解消]
    B --> J
    C --> J
    J --> R[現在状態を再確認]
    R --> N[次に進める仕事を決め直す]
同じ目的を見る。しかし、同じ作業場所へ無制限に書き込まない。
この分離が、複数AI実行役運用の出発点です。
「別ファイルだから安全」ではない
物理的なファイル競合がなくても、意味上の競合は起こります。
たとえば、
AI A
  API仕様を変更

AI B
  古いAPI仕様を前提にtestを追加
なら、Git上のファイルは別でも仕事は衝突しています。
したがって、並行化の判断では少なくとも次を確認します。
flowchart TD
    accTitle: 並行実行してよい仕事かを判断する流れ
    accDescr: 依存、変更対象、前提の鮮度、能力と権限を確認して、直列化、再確認、別実行役、人間判断、並行候補へ分ける。
    A[候補タスク] --> B{明示された依存で直列化が必要?}
    B -- はい --> S[直列で進める]
    B -- いいえ --> C{同じ変更対象や責任主体を触る?}
    C -- はい --> S
    C -- いいえ --> D{前提と証拠は現在も有効?}
    D -- いいえ / 不明 --> R[再確認]
    D -- はい --> E{能力と権限がある?}
    E -- いいえ / 不明 --> H[別実行役 / 人間判断]
    E -- はい --> P[並行候補]
重要なのは、「問題が見えない」を「安全」と扱わないことです。
依存関係を見つけられなかったことと、依存が存在しないことは同じではありません。
分けて配るより、戻す方が難しい
仕事を複数へ配ることを 「分配」、戻して一つにすることを 「合流」 と呼ぶと、複数AI実行役運用の難所は合流側に集まりやすくなります。
flowchart LR
    accTitle: 分担した仕事を合流する流れ
    accDescr: 一つの仕事を調査、実装、レビューへ分け、それぞれの結果を合流し、版、証拠、整合性を確認して現在状態へ反映する。
    T[一つの仕事] --> A[調査]
    T --> B[実装]
    T --> C[レビュー]
    A --> J[合流]
    B --> J
    C --> J
    J --> V[版 / 証拠 / 整合性を確認]
    V --> S[現在状態へ反映]
合流は単なるGitのマージではありません。
確認したいのは、たとえば次です。
- どの版を前提にした結果か
- 二つの結果は両立するか
- 一方の変更で他方の前提が古くなっていないか
- 必要なレビュー・権限が満たされているか
- 統合後に目的へ本当に近づいたか
つまり、
合流
  = 結果の識別
  + 証拠
  + 矛盾解消
  + 権限
  + 現在状態の再確認
です。
「終わりました」をそのまま完了にしない
AIが、
修正しました。テストも通りました。
と返しても、それだけで仕事を閉じるのは危険です。
- 古いブランチを直していた
- Pull Requestの先端が動いていた
- テスト対象と現在コードが違った
- 別のAIが同じ前提を変更していた
- マージや公開の人間判断がまだ必要だった
ということがあるからです。
実行役の完了報告
      ↓
差分 / テスト / レビュー / 証拠
      ↓
現在のGitHub・正本を再確認
      ↓
本当に必要な状態変化が起きたか判定
ここでも、
実行役から結果が返った
  !=
状態変化が受け入れられた
を分けます。
状態が変わったら、必要な範囲だけ考え直す
一つ結果が戻るたびにプロジェクト全体を最初から考え直すのは高コストです。
一方で、一度作った計画を固定すると古くなります。
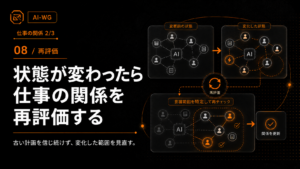
そこで、重要な変化が起きたら、影響した判断だけを再確認します。
flowchart LR
    accTitle: 状態変化後に必要な判断だけを更新する流れ
    accDescr: 重要な状態変化から影響する判断を特定し、古くなった判断だけを無効化して必要な情報を再確認し、次の作業候補を更新する。
    M[重要な状態変化] --> I[影響する判断を特定]
    I --> X[古くなった判断を無効化]
    X --> O[影響しない判断は保持]
    O --> Q[必要な情報だけ再確認]
    Q --> N[次の作業候補を更新]
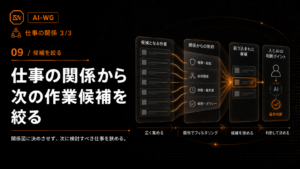
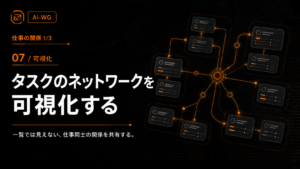
この「影響範囲を限定した再評価」が、07〜09で扱った仕事の関係と、複数AI実行役の運用をつなぐ部分です。
worktreeは重要だが、オーケストレーションそのものではない
複数AIが同じリポジトリへ書き込むなら、Git worktreeで物理的な作業場所を分けるのは有効です。
しかし、
worktreeによる隔離
  = どこへ書くか

複数AI実行役 governance
  = 何を誰へ渡し
    何を同時に進め
    どう戻し
    何を採用するか
であり、同じ責務ではありません。
物理的な隔離の詳細は、次の記事で扱います。
並列化しない方がよい仕事もある
複数AIを使えるからといって、何でも並列化すると逆に遅くなります。
特に次の仕事は直列化や単一の責任者が適することがあります。
- 共通インターフェースやスキーマの最終決定
- 権限や方針の変更
- 複数結果の統合
- 最終確認
- マージ / 公開など不可逆な遷移
- まだ問題定義自体が揺れている仕事
目的はAIの稼働率を最大化することではありません。
全体の収束時間と、結果の一貫性を良くすること。
です。
最小構成は「2人のAI + 1つの合流点」から
最初から自律的なAI群を作る必要はありません。
小さく始めるなら、次で十分です。
一つの共有作業項目
      ↓
AI A ── 独立した作業面
AI B ── 独立した作業面
      ↓
一つの統合責任者
      ↓
現在状態を再確認
      ↓
次の仕事
重要なのは、AIの数ではなく、
- 共有する仕事の識別
- 書き込み境界
- 返却される証拠
- 合流責任者
- 再確認
が明示されていることです。
まとめ
複数AIで仕事を速くしたいなら、まず複数AIを起動するのではなく、一つの仕事を複数の実行役が扱える形へ外部化する必要があります。
仕事の意味を共有
      ↓
安全に分ける
      ↓
隔離して実行
      ↓
証拠と一緒に結果を戻す
      ↓
合流する
      ↓
現在状態を再確認
      ↓
次の仕事を決め直す
複数AI実行役の本質は「同時実行」ではありません。
仕事の意味を壊さずに、分けて、戻して、続けられること。
そこが設計の中心です。

コメント