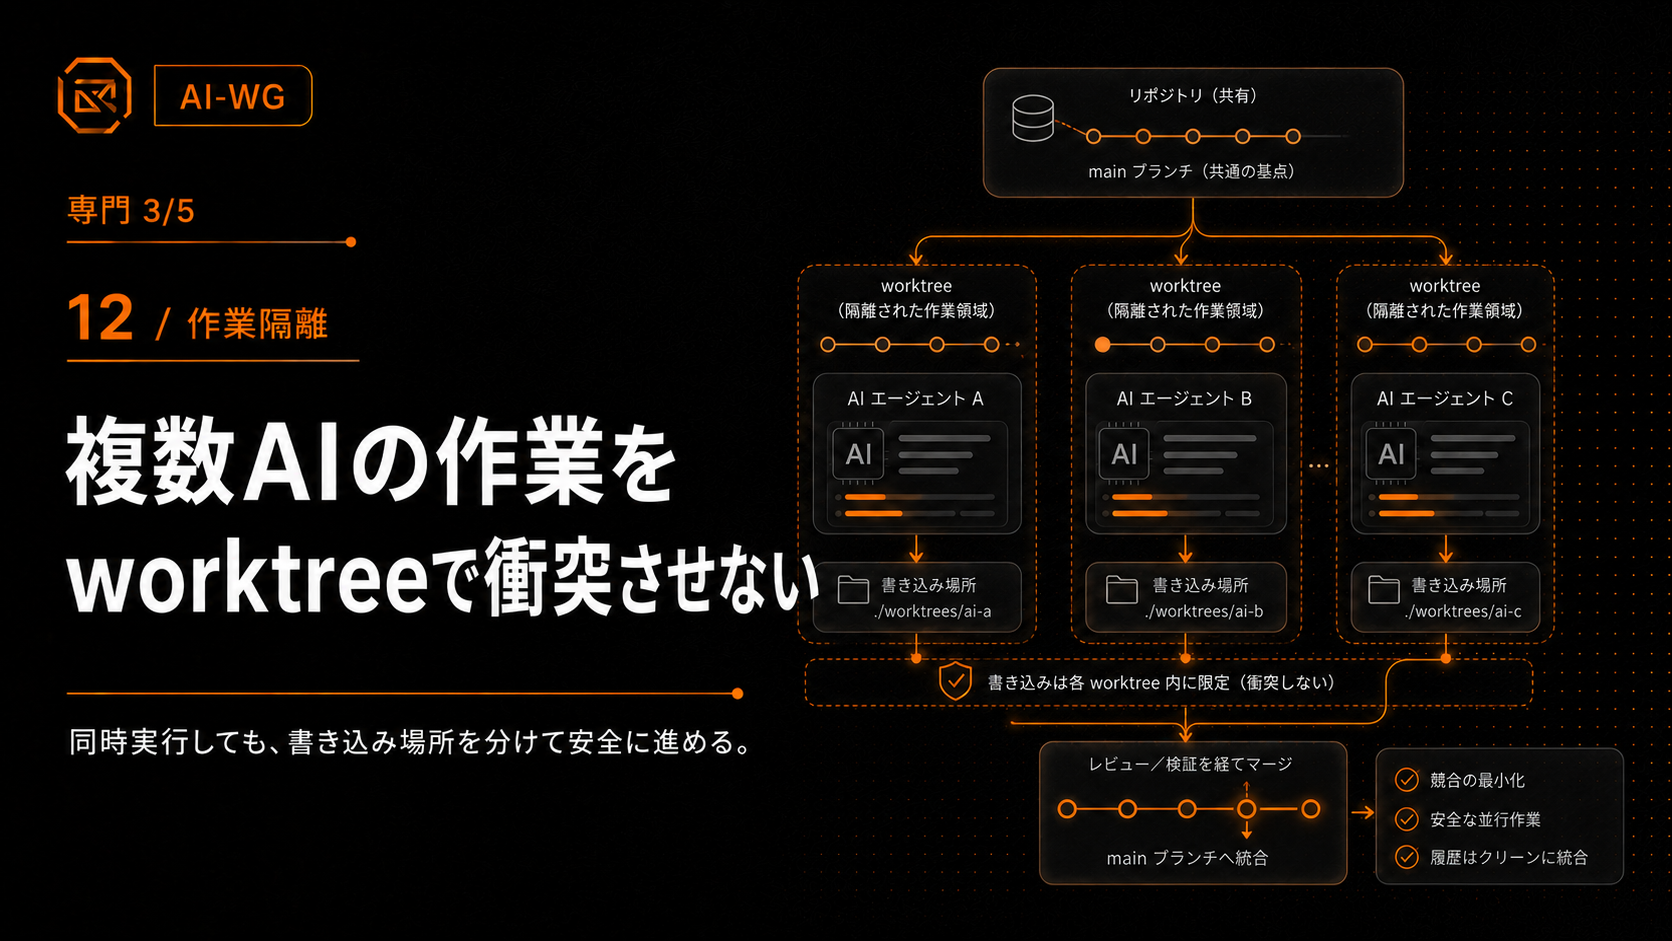
ブランチを分けるだけでは足りなかった
AI Work Governance|専門テーマ — 作業場所の隔離
Claude Codeが実装し、別の画面ではCodexがレビュー対応を進め、人間も同じリポジトリを確認している。
複数のAIコーディング実行役を使い始めて、最初に困ったのは高度なAIの自動連携ではありませんでした。
同じ作業ディレクトリを、誰が使っているのか分からなくなった。
ブランチを分けても、同じ作業ツリーに未コミット変更が残っていれば別の実行役から見えます。前のセッションが異常終了すれば、途中状態だけが残ります。
Git worktreeは、一つのリポジトリへ複数の作業ツリーを関連付けられるGitの機能です。
しかし、複数AIで使うなら、単にworktreeを作るだけでは足りません。
worktreeを「ブランチを開く場所」ではなく、「AI実行役 + セッションに対応する物理的な書き込み境界」として扱う。
この記事では、その考え方を整理します。
Issue・ブランチ・worktreeは同じものではない
最初は、Issue番号ごとにworktreeを作れば分かりやすいと考えました。
Issue A
  ├─ ブランチ: example/feature-a
  └─ worktree: セッション-a
しかし、セッション開始時にはIssueがまだ決まっていないことがあります。一つのセッションで複数Issueを扱うこともあります。
そこで責務を分けます。
| 対象 | 主な識別 | 主な責務 |
|---|---|---|
| Issue | 作業項目 | 問題・目的・完了条件 |
| ブランチ | Issue / 変更 | 変更履歴 |
| worktree | AI実行役 + セッション | 物理的な作業隔離 |
| Pull Request | ブランチ + Issue | 差分・検証・レビュー |
| セッション状態 | AI実行役 + セッション | 現在の所有状態 |
flowchart TB
    accTitle: Issue、ブランチ、worktree、Pull Requestの責務
    accDescr: Issueは解く対象、ブランチは変更履歴、AI実行役とセッションはworktreeの物理作業場所に対応し、ブランチとworktreeの成果がPull Requestへ接続する。
    I[Issue / 何を解くか] --> B[ブランチ / 変更履歴]
    S[AI実行役 + セッション] --> W[worktree / 物理作業場所]
    B --> P[Pull Request / 差分・検証]
    W --> P
一つに潰すのではなく、互いに参照させます。
Worktreeはセッション開始時ではなく「最初の書き込み直前」
worktreeをいつ取得するかも重要です。
読むだけのセッションで毎回worktreeを作ると、不要な作業場所と終了処理が増えます。
逆に、書き込みを始めた後で隔離しても遅すぎます。
現在の設計は次です。
flowchart LR
    accTitle: 最初の書き込み直前にworktreeを取得する流れ
    accDescr: セッション開始後は読み取り専用で観測し、リポジトリ内容を書き込みまたは編集する最初の意図が発生した時点で専用worktreeを取得して編集を始める。
    A[セッション開始] --> B[読み取り専用で観測]
    B --> C{リポジトリ内容を書き込み・編集する?}
    C -- いいえ --> B
    C -- はい --> D[セッション専用worktreeを取得]
    D --> E[worktreeへ移動]
    E --> F[実行役とセッションの所有情報を確認]
    F --> G[編集開始]
つまり境界は、
セッション start
でも
Issue確定
でもなく

最初のリポジトリ内容への書き込み意図
です。
これは「すべての書き込みを強制遮断するサンドボックスが完成している」という意味ではありません。現在の運用契約と実装が持つ境界を、過大評価せず説明する必要があります。
main側のworktreeを共有実装場所にしない
セッション用worktreeを作っても、main側のworktreeで普通に実装を続ければ、再び変更が集中します。
そこで概念的には、
実行面
  = セッション worktree

記録・同期面
  = main側のworktree
と分けます。
main側は短い同期や記録、終了処理へ寄せ、長時間の実装や未コミット差分は専用worktreeへ置く。
これにより、mainを「誰でも書く共有デスク」にしないようにします。
Gitだけでは「誰が作業中か」は分からない
git worktree listを見れば、worktreeとブランチは分かります。
しかしGitだけでは、
- どのAI実行役が使っているか
- どのセッションが所有しているか
- プロセスがまだ生きているか
- 異常終了後の残骸か
- 別環境から利用中か
までは十分に表現できません。
そのため、必要に応じてセッション所有情報の補助情報を持ちます。
実行役: AI-A
セッション: A
worktree: worktrees/a
ブランチ: example/feature-a
状態: 使用中
ただし、この台帳も単独の真実ではありません。
Git / ファイルシステム / プロセス / 遠隔側の状態
        +
セッション所有記録
を照合して使います。
「他のAIがいる」と「書いてはいけない」は別
並行状態だけで危険度を決めるのも粗すぎます。
読むだけの作業と、共有契約を変更する作業では意味が違います。
考えるべきは、少なくとも二軸です。
quadrantChart
    accTitle: 同時実行と書き込み影響による作業リスク
    accDescr: 横軸は書き込み影響の小から大、縦軸は同時実行の少から多で、両方が大きいほど強い隔離と調整が必要になる。
    title 同時実行と書き込み影響
    x-axis 書き込み影響 小 --> 書き込み影響 大
    y-axis 同時実行 少 --> 同時実行 多
    quadrant-1 強い隔離と調整
    quadrant-2 調整が必要
    quadrant-3 低リスク
    quadrant-4 書き込み境界が必要
    読み取り専用: [0.15, 0.20]
    多数の調査: [0.20, 0.75]
    独立実装: [0.65, 0.35]
    大きな共有変更: [0.85, 0.80]
終了処理は「消せるか」と「消してよいか」を分ける
worktreeを作るより、片付ける方が危険なことがあります。
ディレクトリが存在しているから削除する、プロセスが見えないから削除する、では不十分です。
終了候補
  ↓
未コミット変更はないか
  ↓
必要な成果はブランチ / PRへ保全されたか
  ↓
他のセッション / 実行環境から利用中でないか
  ↓
削除権限・ライフサイクル条件を満たすか
  ↓
後片付け
重要なのは、
技術的には削除できる
  !=
運用上安全に削除できる
です。
Windows / WSLのような複数環境では、存在と操作可能性を分ける
一つのリポジトリをWindowsとWSLの両方から扱う場合、パス表現やプロセスの可視性が違います。
したがって、
worktreeが存在する
このworktreeをこのセッションが所有している
この実行環境から安全に操作できる
を別の問いとして扱う方が安全です。
「見える」から「触ってよい」を推測しないのは、権限の考え方と同じです。
worktreeは複数AI実行役の全部ではない
worktreeで解決できるのは主に物理的な書き込み競合です。
解決しないものもあります。
worktree
  ✓ 作業場所の隔離
  ✓ 未コミット差分の分離

worktreeだけでは解決しない
  ✗ 意味上の依存関係
  ✗ 権限
  ✗ 結果の合流
  ✗ 古くなった前提
  ✗ 最終的な受け入れ判断
したがって、前の記事で扱った複数AI実行役の論理的な分担・合流の下に、worktreeという物理層があると考えると分かりやすいです。
最小運用モデル
複数AIで同じリポジトリを扱うときの最小形は、次のようになります。
読み取り専用で現状確認
      ↓
書き込みが必要
      ↓
セッション専用worktreeを確保
      ↓
Issue / ブランチを選ぶ
      ↓
所有関係を確認
      ↓
編集・テスト・コミット
      ↓
Pull Requestへ結果を出す
      ↓
保全確認
      ↓
セッション終了 / 後片付け判断
ブランチだけでも、worktreeだけでもありません。
作業項目、変更履歴、物理作業場所、セッション所有情報を別々の責務として接続する。
これが中心です。
まとめ
Git worktreeは、複数AI運用の万能なオーケストレーターではありません。
しかし、
「誰が、どのセッションで、どこへ書いているか」を物理的に分ける
ための強い部品になります。
複数AI実行役運用では、
論理的な仕事の分担・合流
        ↓
物理的な書き込み隔離
        ↓
Git worktree
と位置付けると、責務を混同しにくくなります。

コメント