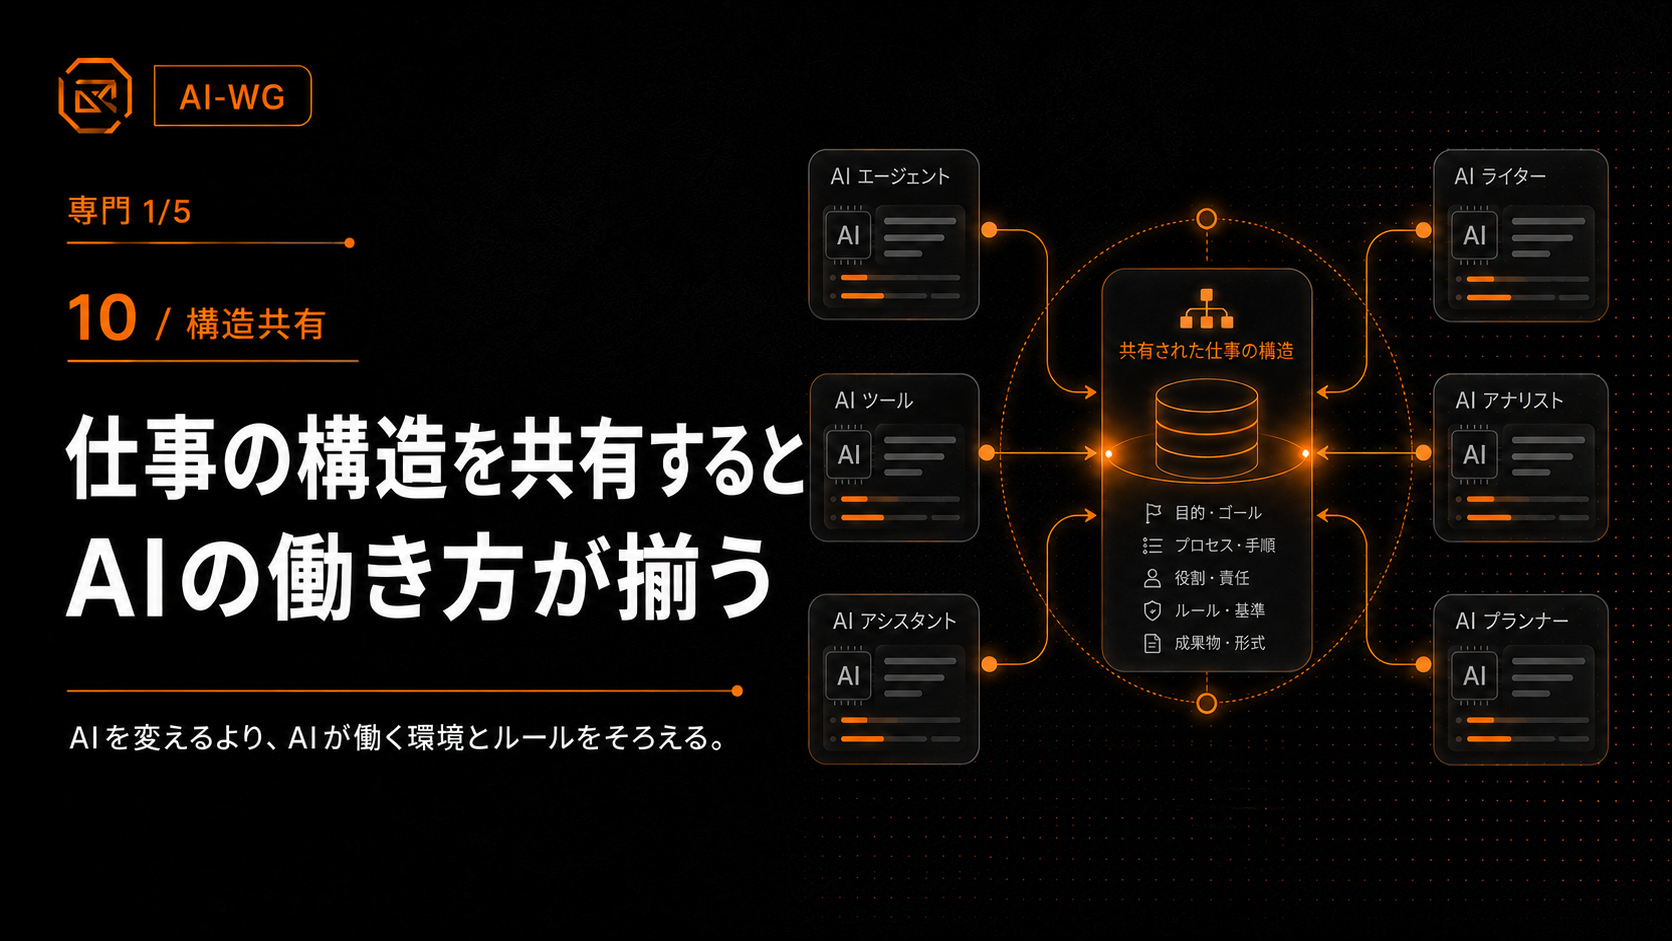
AIを変えたのではなく、AIが働く「仕事の構造」を共有した話
AI Work Governance|実運用ケース
Claude CodeやCodexで複雑な作業を安定させるために、リポジトリ側の契約、権限、再利用手順、読む順序、検証ルールを整えていきました。
すると、少し意外な変化がありました。
同じリポジトリを扱うChatGPTの仕事まで、以前より安定したように感じる場面が増えたのです。
ただし、これは「ルールを書けばAIモデルの知能が上がる」という話ではありません。モデル、利用できるツール、文脈、私自身の指示の出し方も変化しています。因果関係を証明したわけではありません。
この記事で扱うのは、もっと限定した観察です。
AIの外へ、仕事の意味・権限・手順・状態を残しておくと、異なるAI実行役でも同じ仕事構造を再利用しやすくなる。少なくとも実運用では、それがChatGPTの仕事にも効いているように見えた。
flowchart LR
    accTitle: 仕事構造を外部化したときの観察
    accDescr: 仕事構造をリポジトリへ外部化し、別のAI実行役が参照し、ChatGPTでも境界を保った仕事が観察されたが、知能向上の因果証明ではないことを示す。
    A[仕事構造をリポジトリへ外部化] --> B[契約・権限・手順・証拠]
    B --> C[別のAI実行役も同じ構造を参照]
    C --> D[ChatGPTでも境界を保った仕事を観察]
    D -.-> E[知能向上の因果証明ではない]
整えたのは、巨大なプロンプトではない
外へ出していったのは、主に次のような責務です。
リポジトリ / Vault
├─ 契約
│   └─ 何を満たせば仕事が成立するか
├─ 権限
│   └─ 何をしてよいか
├─ 手順(Skill)
│   └─ どう進めるか
├─ 正本 / 読む順序
│   └─ 何を正しい情報として、どの順で読むか
└─ 証拠 / 作業項目
    └─ 何を根拠に、どこから仕事を続けるか
たとえば「このPull Requestをレビューして」と頼まれたとき、AIが毎回ゼロから、
- どこまで読むのか
- 修正までしてよいのか
- マージしてよいのか
- 古い引き継ぎ情報を信じてよいのか
- 何を確認すれば完了なのか
を推測しなくてよいようにする。
仕事の判断材料を、会話ではなくリポジトリ側へ残す。
これが出発点でした。
同じ仕事構造を共有する経路は二つある
ここは混同しやすいので、分けて考えます。
flowchart TB
    accTitle: 二つの仕事構造共有経路
    accDescr: 再利用手順の正本から、実行環境側で手順を共有する経路と、リポジトリを介して仕事の意味を共有する経路を示す。
    S[再利用手順と仕事情報の正本]
    S --> N[実行環境側で再利用手順を共有]
    N --> N1[Codex]
    N --> N2[Claude Code]
    N --> N3[Cursor / OpenClaw]
    S --> R[リポジトリ経由で仕事の意味を共有]
    R --> R1[Issue / Pull Request]
    R --> R2[契約 / 権限]
    R --> R3[手順定義 / 証拠]
    R1 --> C[ChatGPT]
    R2 --> C
    R3 --> C
1. 実行環境側で再利用手順を共有する
この運用では、再利用する手順の本体を一つの正本として管理し、Codex、Claude Code、Cursor、OpenClawなどが参照する手順領域へ接続する仕組みを使っています。
ただし、
同じ手順の正本を配る
  !=
すべての実行環境が同じ挙動をする
です。
実際にどの手順領域を読むかは実行環境ごとに異なり、現在の接続状態を確認する必要があります。
2. リポジトリ経由で仕事の意味を共有する
ChatGPTについては、「ローカルの手順接続をそのまま利用している」と説明するべきではありません。
一方で、GitHub上のIssue、Pull Request、契約、手順定義、証拠、読む順序など、リポジトリに残った仕事構造は参照できます。
つまりChatGPTでは、
同じ手順を同じ方法で読み込むのではなく、同じ仕事の意味をリポジトリ経由で再利用している。
と考える方が正確です。
実例1 — 「できる」から「やってよい」を推測しない
あるGitHub操作の安全確認機構では、変更操作へ進む前に、
- 人間からその操作をしてよいと許可されているか
- 作業ルール上、その操作が許されているか
- 現在の情報が十分に新しいか
を別々に確認する実装を行いました。
flowchart TD
    accTitle: 変更操作へ進む前の権限確認
    accDescr: 人間の許可、作業ルール上の権限、現在情報の鮮度を順に確認し、不足があれば停止する流れを示す。
    A[変更操作の候補] --> B{人間の許可はある?}
    B -- 未取得 --> X1[停止]
    B -- あり --> C{作業ルール上の権限は解決済み?}
    C -- 未解決 --> X2[停止]
    C -- 解決済み --> D{現在情報は十分に新しい?}
    D -- 不足 --> X3[停止]
    D -- 十分 --> E[使用可能な操作を選ぶ]
    E --> F[実際の変更実行は別責務]
ここで大切なのは、
できる
  !=
やってよい
という境界です。
さらに、安全確認機構が「どの操作を使えるか」を判断しても、それ自体が変更を実行するわけではありません。
この実装はChatGPTを実行役として作成・検証されました。
ここから言えるのは「ChatGPTが賢くなった」ことではありません。
リポジトリ側に明示された権限境界を読み、それを勝手に拡張しない仕事をChatGPTでも遂行できた。
という限定された事実です。
実例2 — 前の会話を覚えるより、現在状態を取り直す
もう一つは、作業再開の仕組みです。
引き継ぎメモに「次はこのPull Requestを直す」と残っていても、その後マージされているかもしれません。
そこで、引き継ぎ情報を現在状態の正本ではなく、再開するための手掛かりとして扱うようにしました。
flowchart LR
    accTitle: 作業再開時の現在状態再構築
    accDescr: 前回の再開手掛かりから参照先を解決し、現在状態を再確認して、いまの仕事を再構築する流れを示す。
    A[前回の再開手掛かり] --> B[参照先を解決]
    B --> C[GitHub等を現在状態で再確認]
    C --> D[前回情報と現在状態を比較]
    D --> E[いまの仕事を再構築]
つまり、
「前のAIがそう言っていたから続ける」
のではなく、
「前回の手掛かりから、いま何が正しいかを取り直す」
ようにします。
これはAI実行役をまたぐときに特に効きます。
次のAIが前回の会話を完全に知っている必要はありません。参照先と責務が残っていれば、現在の状態から仕事を再構築できます。
会話を覚え続ける
  より
現在状態から仕事を再構築できる
という設計です。
実例3 — 新しい能力を見つけても、追加しない
新しい外部接続やツールの能力を調査する仕組みでも、発見した能力をそのまま導入へ結び付けないようにしました。
実際の調査では、
何もしない
様子を見る
現在は採用しない
という判断が残っています。
複数の能力を調べた結果、現在の中核システムへ追加する候補が0件でも、それを失敗とは扱いません。
ここで守っているのは、
能力を発見することと、採用することは別である。
という境界です。
AIに新しい道具を探させると、「見つけたから使おう」という方向へ流れやすい。そこで、何もしない判断も正規の成果として残す。
これも、AI実行役をまたいで再利用できる統治構造の一例です。
なぜChatGPTにも効いたように見えたのか
ここからは推論です。
リポジトリ側の仕事構造が整ったことで、AIが毎回その場で解かなければならない問題が減ったことが、一因ではないかと考えています。
以前は一つの依頼から、
何を読む?
何が正本?
どこまでやる?
変更してよい?
終わった条件は?
前回の情報はまだ正しい?
を、その場で全部解釈する必要がありました。
外部化後は、
読む順序
  ↓
現在の責任主体
  ↓
権限
  ↓
再利用手順
  ↓
現在状態
  ↓
証拠
という再利用可能な経路ができます。
AIモデルの推論が不要になるわけではありません。
しかし、
何を推論してよく、何を推測で埋めてはいけないか
が明確になります。
私が感じた「ChatGPTまで仕事がうまくなった」という実感は、この変化と整合します。
ただし、これは寄与の可能性を示す説明であって、単独原因を証明するものではありません。
共有するのは「実行環境」ではなく「仕事の意味」
Claude Code、Codex、ChatGPT、OpenClawは同じものではありません。
共有しやすいものと、実行環境ごとに異なるものは分ける必要があります。
| 比較的共有しやすいもの | 実行環境ごとに異なるもの |
|---|---|
| 契約の意味 | 利用できるツール |
| 権限の境界 | 権限を強制する仕組み |
| 再利用手順 | サンドボックス |
| 正本 / 読む順序 | ファイルシステムへのアクセス |
| 作業項目の識別 | メモリー |
| 検証条件 | フック |
| 証拠 | 実行ライフサイクル |
この設計が目指しているのは、実行環境そのものを複製することではありません。
目指しているのは、
実行役が変わっても、仕事の意味と統治境界を持ち越せること。
です。
構造を増やせば増やすほど良いわけでもない
仕事構造を外へ出せば、何でも良くなるわけではありません。
契約、再利用手順、方針を増やしすぎると、
- どれを読めばよいか分からない
- 古いルールが残る
- 同じ責務を複数の文書が所有する
- 読み込みコストが増える
- 実行環境ごとの保守が増える
という別の問題が起こります。
つまり、
AIの外へ構造を出すことと、構造を増やし続けることは同じではない。
必要なのは、仕事の意味を持続させるための必要最小限の責務分離です。
AIを同じにする必要はない
この経験から得た一番大きな気付きは、AIを全部同じにする必要はない、ということでした。
Claude CodeにはClaude Codeの強みがあります。CodexにはCodexの実行環境があります。ChatGPTにはChatGPTの接続方法があります。
それでも、
何を達成するのか
何を正本として読むのか
何をしてよいのか
どう進めるのか
何をもって成立とするのか
をAIの外へ残しておけば、実行役を交換しても仕事の意味を持ち越しやすくなります。
AIを変えたのではない。AIが働く仕事環境を整えた。
より厳密には、
仕事環境を整えた時期と、ChatGPTの仕事が安定したと感じる時期が重なった。そしてリポジトリ上の証拠を見る限り、別のAI実行役でも同じ統治境界を再利用できている。
ここまでなら、現在の証拠から言えます。
まとめ
仕事の構造をリポジトリへ外部化
        ↓
契約 / 権限 / 手順 / 正本 / 証拠
        ↓
AIが毎回ゼロから再発明しなくてよくなる
        ↓
異なるAI実行役でも同じ仕事構造を参照しやすくなる
        ↓
ChatGPTでも境界を保った仕事が観測された
ここから言えるのは、AIモデルの知能が上がったということではありません。
言えるのは、
AIの外に仕事の意味を残しておくと、AI実行役をまたいで仕事を再利用しやすくなる。
ということです。
この考え方の全体像は、公開済みの「AI Work Governanceとは何か」で整理しています。この記事は、その設計思想が実運用でどう見えたかを示す、一つの事例です。

コメント