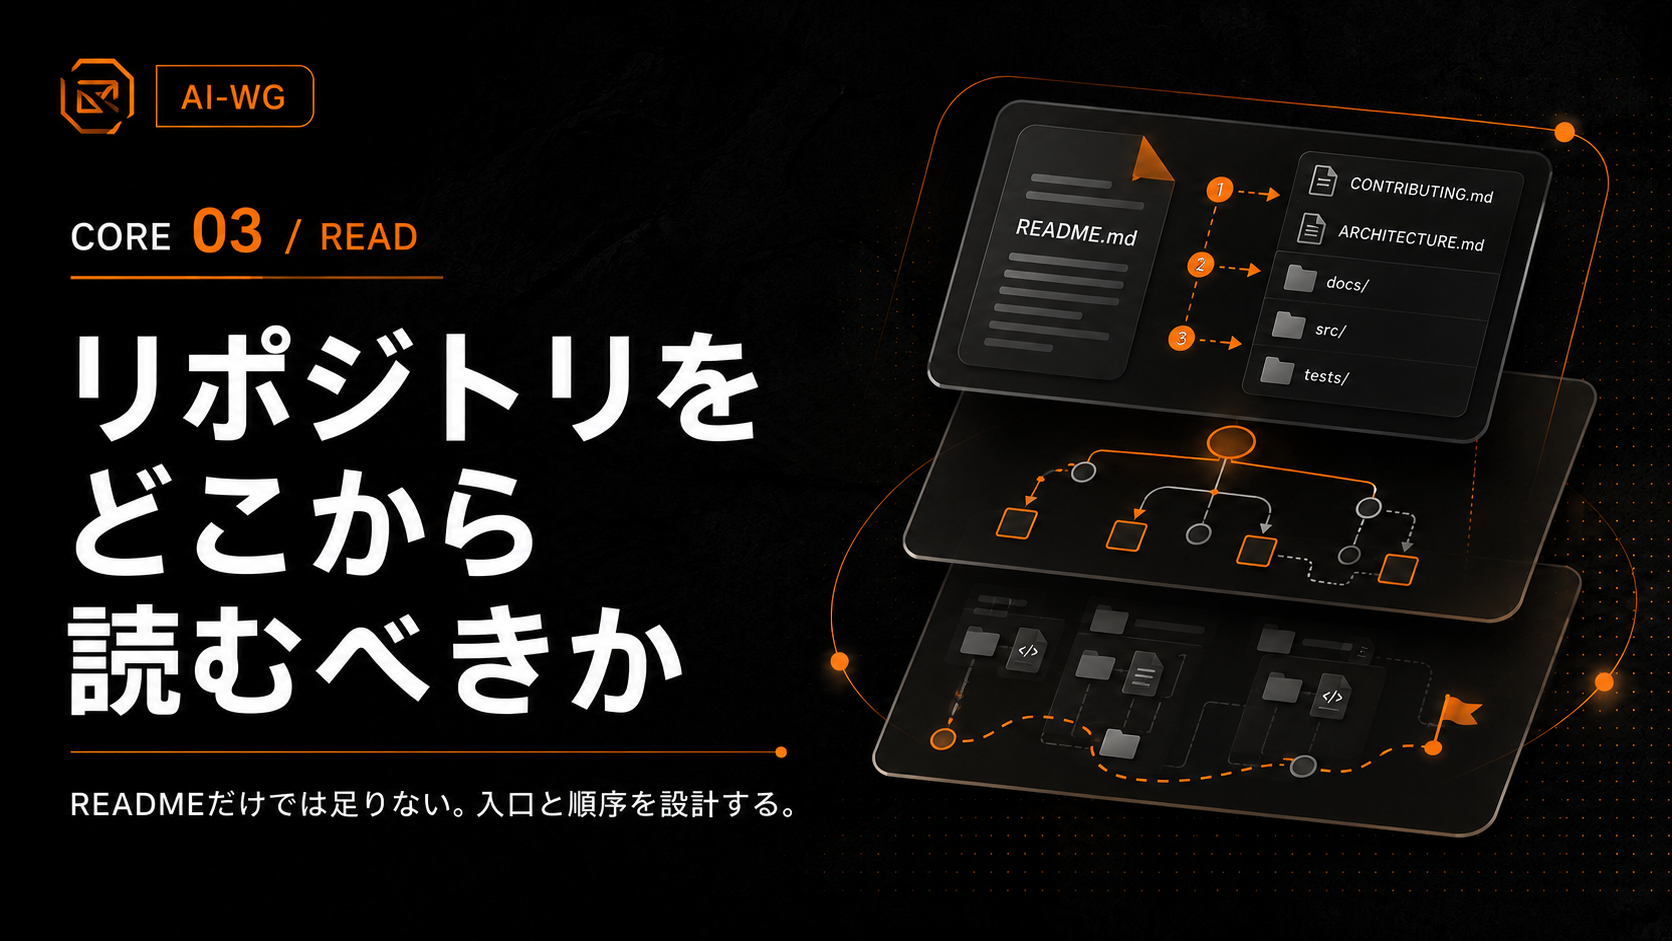
READMEだけでは足りない — 読む順序・正本・権限を設計する
AI Work Governance|基礎 3/6 — 読む順序
AIエージェントにリポジトリを渡すと、多くのファイルを読めます。README、設計書、Issue、Pull Request、コード、ログ、メモ。検索もできます。
読めることと、何から読むべきか分かることは同じではありません。
最新の文書が正本とは限りません。検索で最初に出たファイルが、その意味を決める文書とも限りません。前回の引き継ぎメモは再開の手掛かりにはなっても、現在のIssueやPull Requestの状態そのものではないかもしれません。
どこから入り、何を地図として使い、どこで正しい情報を確認し、どこまで読めば止めてよいか。この順序を設計します。
リポジトリは「ファイルの山」ではなく「判断の入口」を持てる
READMEは、目的、セットアップ、構成、使い方を短時間で理解するのに便利です。しかしAIエージェントが実際の作業へ入るときには、もう少し違う情報も必要になります。
どの文書を最初に読むか
指示が競合したら何を優先するか
この場所だけに適用される規則はあるか
実行環境固有の案内は正本か、入口か
再利用する手順と操作権限はどこで分かれるか
今回に関係ない巨大な資料群まで読む必要があるか
前回のメモをどこまで信用してよいか
入口文書
  = どこを見れば答えがあるかを示す地図
実装ではAGENTS.mdのようなファイルにこの役割を持たせることができますが、重要なのはファイル名ではありません。最初の一枚から、必要な正本へたどれることが重要です。
「最初に読む文書」と「最終的に信じる文書」は同じとは限らない
入口と正本は別です。
INDEX
  ↓
今回の問いを分類する
  ↓
その意味を決める文書を特定する
  ↓
必要な範囲を読む
INDEXは地図として便利ですが、その一行がすべての意味を決めるとは限りません。同じことは検索にも言えます。
検索
  = 候補を見つける

正本の確認
  = どの候補が今回の問いを決めるか確認する
「それらしい文書を見つけた」と「この文書がこの意味を決める」を分けるだけでも、AIの読み方はかなり安定します。
新しい文書が、一番強い文書とは限らない
現在状態を知るときには新しい情報が重要です。しかし、新しさと意味を決める責任は別の軸です。
意味やルールを決める場所
        ↓
正本・規則・設計判断を確認する

現在の状態を確認する場所
        ↓
Issue / Pull Request / 現在のファイル等を確認する
内部のシステム表現では、これらを次のようなtokenで区別することがあります。
Semantic Authority
Current-state Authority
読者が英字を覚えることが目的ではありません。「何が正しい意味を決めるか」と「今どうなっているか」を、同じ情報源へ押し込まないことが重要です。
実行環境ごとの案内を、共通ルールの正本にしない
Claude CodeにはClaude Code向けの案内があり、CodexにはCodex向けの入口があり、ChatGPTにもプロジェクト単位の指示があります。
これらは便利ですが、実行環境ごとの文書へ共通ルールをそれぞれ書き始めると、どれが正しいのか分からなくなります。
共有するルール
     │
     ├─ 実行環境A向けの入口
     ├─ 実行環境B向けの入口
     └─ 実行環境C向けの入口
実行環境ごとの入口
  = その環境でどう受け取るか

共有ルールの正本
  = 共通の意味をどこで決めるか
この分離ができると、実行するAIを交換しても仕事の意味を残しやすくなります。
「全部読ませる」は安全策ではない
- 関係のないルールまで一緒に入る
- 過去の記録と現在の規則が並ぶ
- 局所的な規則と全体ルールを混同しやすくなる
- 読み込み量とツール呼び出しが増える
- 本当に重要な差分が埋もれる
悪い例
リポジトリ
  ↓
全部読む
  ↓
あとで重要なものを考える

よりよい例
リポジトリ
  ↓
入口を読む
  ↓
今回の問いを分類する
  ↓
正本候補へ進む
  ↓
必要な範囲だけ読む
重要なのは「少なく読むこと」そのものではなく、少なく読んでも必要な正本へたどれることです。
仕事の種類によって、読む枝は変わる
リポジトリの入口
        │
        ├─ 規則を知りたい
        │    └─ その規則の正本
        │
        ├─ 再利用手順を実行したい
        │    └─ 手順定義 → 参照する正本
        │
        ├─ 現在のIssue / Pull Requestを知りたい
        │    └─ 現在のGitHub状態
        │
        ├─ 複数領域の境界を知りたい
        │    └─ 構成・責務の正本
        │
        └─ 前回の続きが必要
             └─ 引き継ぎ → 現在の正本へ戻る
内部では、このような読む順序を正規の契約として表現する場合があります。
Read Order Contract
公開記事で重要なのは名前ではありません。最初の数ステップと分岐条件を、毎回ゼロから推測しなくてよいことが価値です。
長期記憶は「毎回全部読むもの」にしない
長期運用では、変わりにくい方針や背景を外へ残すと便利です。ただし、長期記憶にも役割があります。
長期記憶がある
        ≠
すべての仕事で全部読み込む
MEMORY.mdのようなファイルが存在していても、今回の判断に継続情報が必要なら読み、必要なければ読み込まない。この区別は、関係の薄い過去情報が現在の判断へ混ざることも防ぎます。
引き継ぎは「現在状態」ではなく、再開の入口
引き継ぎ
  ↓
前回どこを見ていたか分かる
  ↓
参照されているIssue / Pull Request / 正本を確認する
  ↓
変わり得る情報を現在状態で確認し直す
  ↓
再開する
引き継ぎを信用する役割を限定することが重要です。引き継ぎは「どこから再開するか」を教えてくれますが、現在のPull Requestの対象版、Issueの状態、優先順位まで必ず正しいとは限りません。
では、どこで読むのを止めるのか
今回の判断を変え得る重要な不確実性がなくなったら、読む範囲を止める。
今回の目的が分かった
正本が分かった
現在状態を確認できた
権限境界が分かった
重要な競合情報が見つかっていない
ここまで確認できたら、その仕事に不要な周辺資料まで読み続ける必要はありません。逆に、重要な不確実性が残っているなら止めません。
まとめ:読む順序は、AIの賢さを使うための地図
どこから入るか
何を正本として確認するか
現在状態をどこで取り直すか
実行環境固有の入口と共有ルールをどう分けるか
どこまで読めば十分か
読む順序は、AIの推論を置き換えるためのものではありません。AIが推論するときに、古い情報・弱い情報・関係のない情報へ迷い込むコストを減らす地図です。

コメント